Data & conversieoptimalisatie
Server side tracking: wanneer nodig en wat lost het op?
Lees wanneer server side tracking zinvol is, welke meetproblemen het beperkt en waarom het geen volledige of privacyvrije dataset oplevert.
12 augustus 2026 · 5 min lezen
Server side tracking is nodig wanneer browsermetingen aantoonbaar tekortschieten en betere controle over dataverwerking de extra technische complexiteit rechtvaardigt. Denk aan ontbrekende advertentieconversies, ongewenste gegevens in marketingtags of afhankelijkheid van scripts van externe platforms. Het is geen standaardoplossing voor elk meetprobleem. Wij beoordelen daarom eerst waar gegevens verloren gaan, welke beslissingen daarvan afhangen en of een serveropstelling het probleem werkelijk vermindert.
Wat is server side tracking?
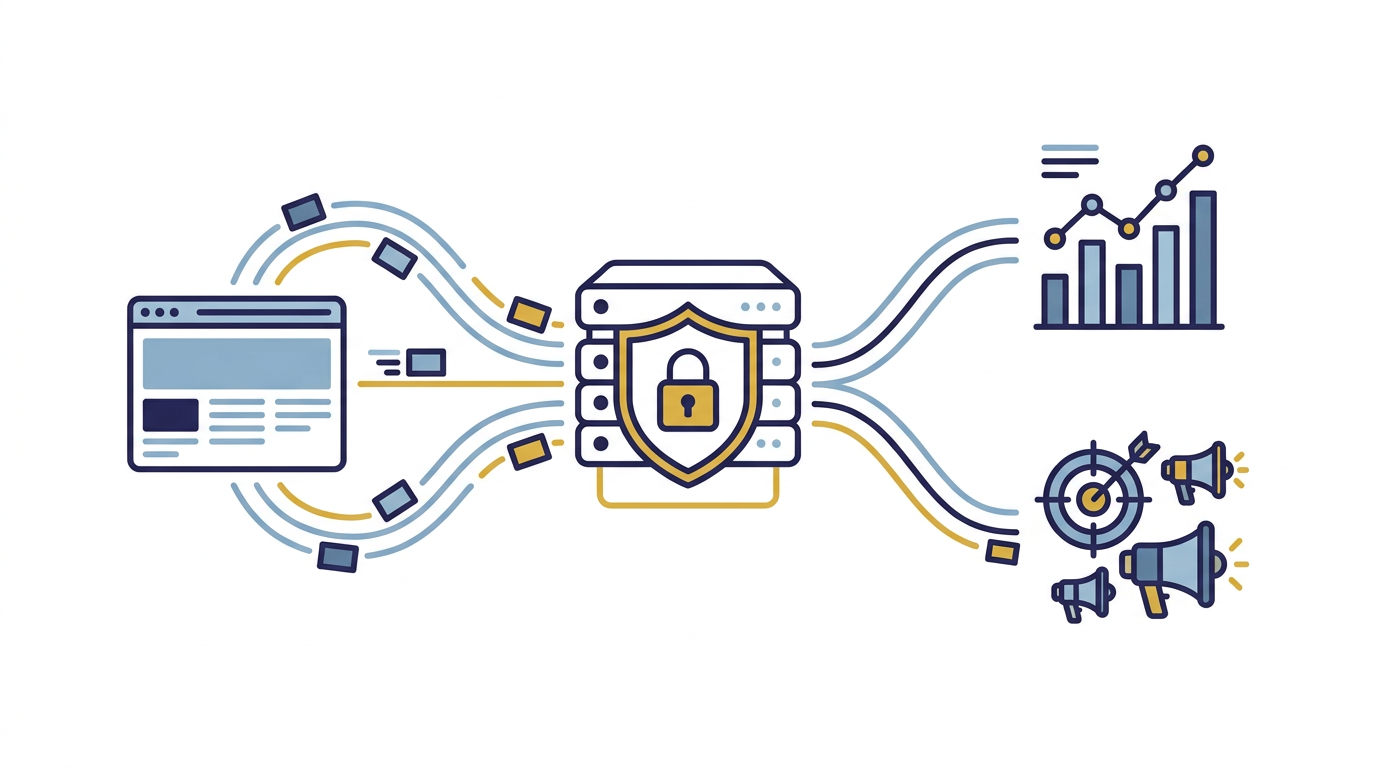
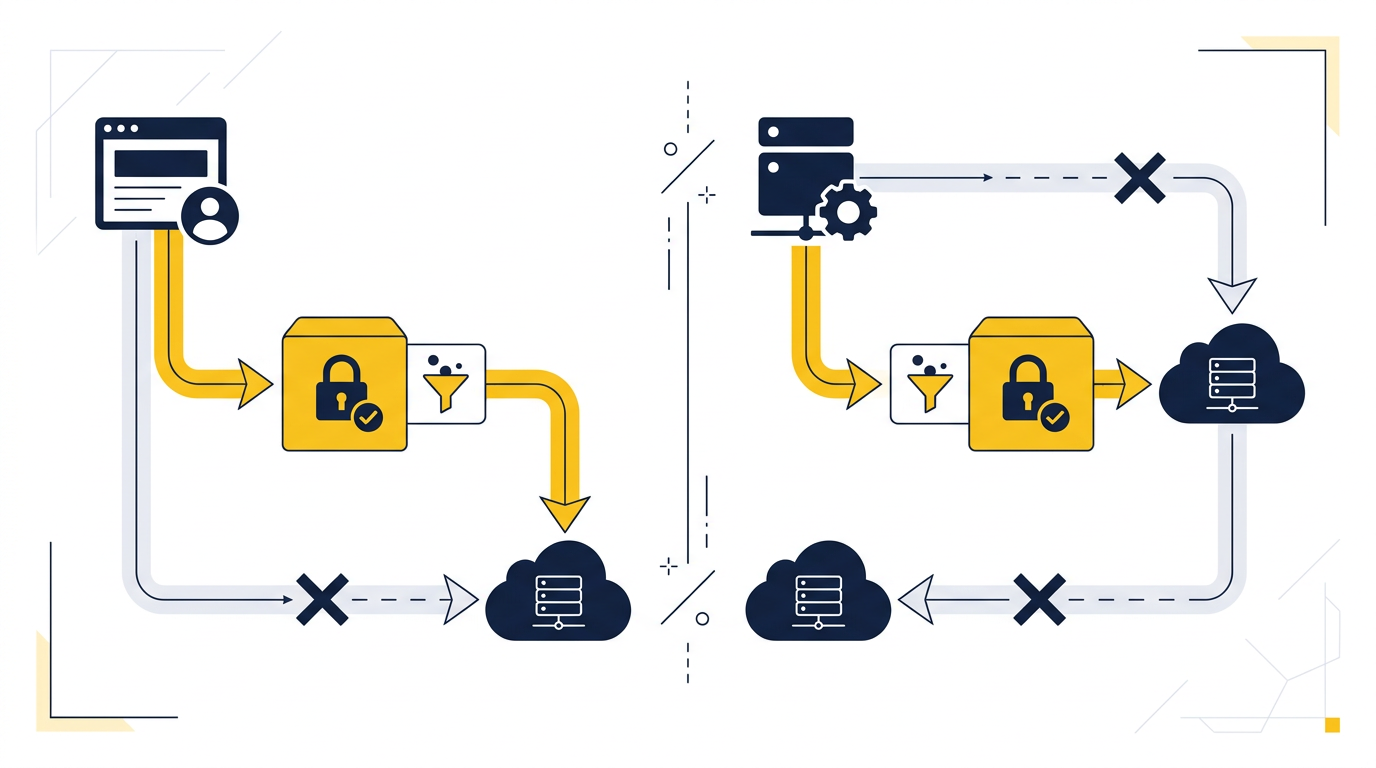
Bij traditionele client side tracking stuurt de browser van een bezoeker gegevens rechtstreeks naar bijvoorbeeld een analytics- of advertentieplatform. Daarvoor worden scripts in de website geladen. Bij server side tracking loopt een deel van die gegevens eerst via een serveromgeving die de organisatie zelf configureert. Die omgeving ontvangt gebeurtenissen, controleert of bewerkt gegevens en stuurt ze daarna door naar gekozen bestemmingen.
Een veelgebruikte inrichting is server-side tagging via een servercontainer. Ook directe koppelingen vanuit een CRM, boekingssysteem of backend naar advertentieplatforms vallen onder servergestuurde meting. De precieze werking verschilt dus per implementatie. Alleen een servercontainer aanmaken betekent nog niet dat alle tracking automatisch via de server verloopt.
Welke problemen lost het op?
Server side tracking geeft vooral meer controle over de route en inhoud van meetgegevens. In plaats van iedere leverancier rechtstreeks vanuit de browser gegevens te laten ontvangen, kan de serveromgeving bepalen welke velden worden doorgestuurd. Zo kunnen onnodige parameters worden verwijderd, namen van gebeurtenissen worden gestandaardiseerd en gegevens naar meerdere toegestane bestemmingen worden verdeeld.
- Minder afhankelijkheid van externe scripts in de browser, omdat een deel van de verwerking naar de server verschuift.
- Meer controle over welke gegevens advertentie- en analyseplatforms ontvangen.
- Betere koppeling tussen websitegebeurtenissen en backendresultaten, zoals een goedgekeurde lead, gerealiseerde verkoop of definitieve hotelboeking.
- Mogelijkheid om browser- en servergebeurtenissen te combineren, mits dubbele registraties met unieke event-ID's worden voorkomen.
- Een eigen first-party subdomein gebruiken voor de meetroute, correct ingericht binnen de technische en juridische voorwaarden.
- Centrale controle op transformaties, filters en doorstuurregels voordat gegevens externe systemen bereiken.
Dat kan vooral relevant zijn wanneer campagnes worden aangestuurd op resultaten die pas buiten de website definitief worden. Een formulierinzending is bijvoorbeeld nog geen gekwalificeerde B2B-lead. Een reserveringsstart is nog geen afgeronde boeking. Door latere statussen vanuit een betrouwbaar bronsysteem terug te sturen, optimaliseren advertentieplatforms op een betekenisvoller resultaat.
Wat lost server side tracking niet op?
Server side tracking maakt metingen niet volledig. Browsers, apparaten en platformen hanteren beperkingen die niet simpelweg verdwijnen doordat gegevens via een server lopen. Een serveropstelling kan gegevensverlies beperken, maar geen universele herkenning van bezoekers garanderen. Cross-device gedrag blijft bijvoorbeeld lastig wanneer er geen geldige, consistente identificatie beschikbaar is.
- Het omzeilt geen toestemming. Als toestemming vereist is, mag de serverroute niet worden gebruikt om die keuze te negeren.
- Het herstelt geen fout meetplan. Verkeerd gedefinieerde gebeurtenissen blijven verkeerde gegevens opleveren.
- Het voorkomt niet automatisch dubbele conversies. Browser- en serverevents moeten zorgvuldig worden ontdubbeld.
- Het maakt attributie niet objectief. Advertentieplatforms gebruiken verschillende modellen en rapportagevensters.
- Het vult ontbrekende brondata niet aan. Een CRM met onvolledige statussen blijft een onbetrouwbare bron.
- Het verwijdert de invloed van adblockers, browserbeleid en platformbeperkingen niet volledig.
- Het maakt first-party data niet automatisch rechtmatig, veilig of onbeperkt bruikbaar.
Ook de term first-party is geen vrijbrief. Het gebruik van een eigen domein of server verandert niet automatisch het doel van de verwerking of de positie van ontvangende leveranciers. Dataminimalisatie, bewaartermijnen, beveiliging, verwerkersafspraken en een correcte toestemmingsinrichting blijven nodig.
Wanneer is server side tracking nodig?
Wij vinden server side tracking passend wanneer er een concreet en aantoonbaar meet- of beheersprobleem is. Een verschil tussen geregistreerde transacties en advertentieconversies is op zichzelf niet genoeg: platforms tellen anders, gebruiken andere tijdzones en schrijven conversies volgens eigen regels toe. Onderzoek daarom eerst of de afwijking technisch is of door rapportagelogica ontstaat.
Een implementatie ligt meer voor de hand wanneer belangrijke conversies structureel niet vanuit de browser kunnen worden bevestigd, wanneer offline leadstatussen nodig zijn voor campagneoptimalisatie of wanneer de organisatie expliciete controle wil over uitgaande parameters. Ook kan het zinvol zijn bij veel marketingtags, zolang de architectuur werkelijk browserscripts vervangt en niet alleen een extra laag toevoegt.
Voor een eenvoudige website met weinig verkeer, een beperkt aantal meetdoelen en goed functionerende client side tracking kan de investering onnodig zijn. De serveromgeving brengt hosting, monitoring, beveiliging, documentatie en onderhoud met zich mee. Elke wijziging in databronnen of platform-API's kan gevolgen hebben voor de werking.
Hoe beoordelen we de noodzaak?
We beginnen niet met een tool, maar met de gegevensstroom. Welke gebeurtenis is bedrijfsmatig relevant, waar ontstaat die gebeurtenis en welk systeem geldt als bron? Daarna vergelijken we browsermetingen, backendregistraties en platformrapportages zonder te verwachten dat de aantallen exact gelijk zijn.
- Leg per conversie vast wat de definitie, bron en unieke identificatie is.
- Controleer toestemming, tagconfiguratie, verwijzingsverkeer, betaal- of boekingsdomeinen en dubbele events.
- Bepaal welke gegevens noodzakelijk zijn en verwijder velden zonder duidelijk doel.
- Kies welke gebeurtenissen vanuit de browser, backend of beide worden verzonden.
- Ontwerp deduplicatie, foutafhandeling en monitoring vóór de livegang.
- Vergelijk na implementatie de datakwaliteit en bruikbaarheid, niet alleen het aantal gemeten conversies.
De kern is dat server side tracking een technische infrastructuur is, geen reparatieknop. Het is nodig wanneer betere gegevenscontrole, backendkoppelingen of robuustere verzending een vastgesteld probleem oplossen. Als definities, toestemming of brondata niet op orde zijn, verplaatst de methode het probleem vooral naar een complexere omgeving.
Meer lezen over dit onderwerp? Data & conversieoptimalisatie
Vragen hierover? Even sparren kan altijd, vrijblijvend.
Plan een gesprek